Как PostgreSQL хранит данные: Физическая структура
Каждая таблица в PostgreSQL — это не просто логическая структура, а сложный физический «пазл» из 8-КБ страниц, где порядок байтов решает всё: от скорости запросов до размера диска.
Давайте рассмотрим небольшой пример:
SELECT PG_COLUMN_SIZE(TRUE); -- 1 байт
SELECT PG_COLUMN_SIZE(1::INT); -- 4 байта
SELECT PG_COLUMN_SIZE(''::TEXT); -- 4 байта
SELECT PG_COLUMN_SIZE(gen_random_uuid()); -- 16 байт
Пока что всё идёт хорошо, давайте попробуем объединить два значения и посмотрим, что изменится:
SELECT PG_COLUMN_SIZE(1::INT, 1::INT); -- ERROR: function pg_column_size(integer, integer) does not exist
К сожалению, так сделать нельзя, и нужно объединить значения в строку:
SELECT PG_COLUMN_SIZE(ROW(1::INT, 1::INT)); -- 32 байта
Откуда взялось 32 байта, ведь должно было быть 8? Всё дело в заголовке страницы:
SELECT PG_COLUMN_SIZE(ROW()); -- 24 байта
SELECT PG_COLUMN_SIZE(ROW(1::INT, 1::INT)) - 24; -- 8 байт
Теперь всё сходится — ROW (24B) + INT (4B) + INT (4B) = 32 байта, успех! Давайте смотреть дальше:
SELECT PG_COLUMN_SIZE(ROW (1::INT, TRUE)) - 24; -- 5 байт
SELECT PG_COLUMN_SIZE(ROW (TRUE, 1::INT)) - 24; -- 8 байт
Почему 4 + 1 ≠ 1 + 4? На самом деле — равно, но тут и начинается самое интересное — паддинги, перед INT нужно добавить 3 байта, чтобы он был выровнен. Давайте разбираться, как это устроено и почему так работает.
Страницы
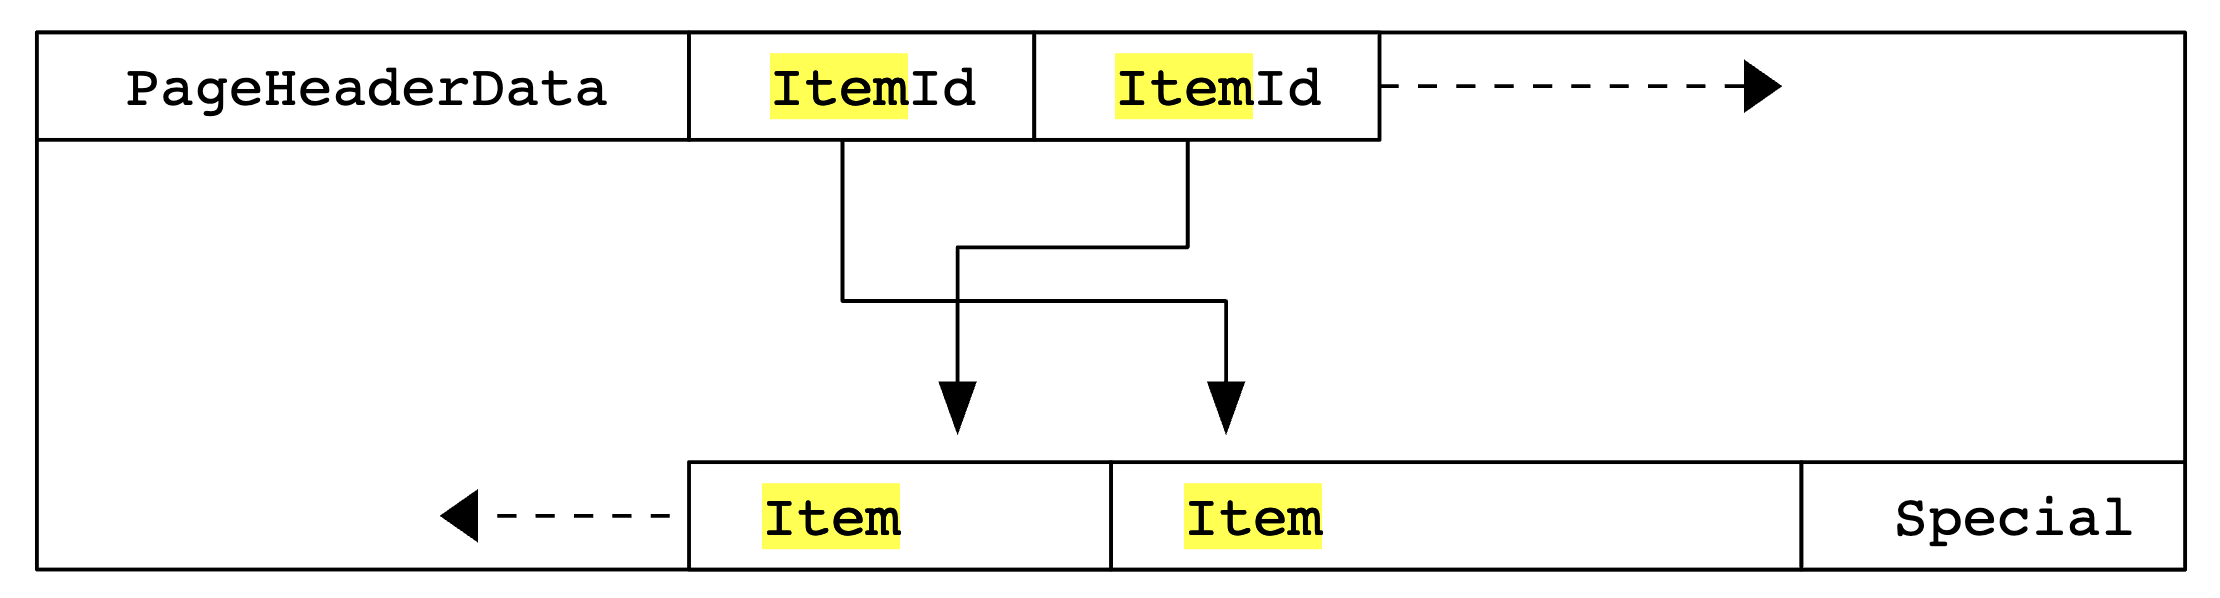
В PostgreSQL страница (или блок) — это единица хранения данных фиксированного размера, обычно 8 КБ, на которой хранятся записи таблицы или индексы. PostgreSQL считывает и записывает данные на диск страницами. Каждая таблица и индекс в базе данных состоит из набора страниц.
- Все данные хранятся в блоках по 8 КБ (по умолчанию), но можно увеличить до 32 КБ.
- Каждая страница содержит:
- Данные заголовка страницы (24 байта): LSN, флаги, указатели на свободное пространство.
- Данные идентификаторов элементов: Массив идентификаторов, указывающих на фактические элементы. Каждый идентификатор представляет собой пару «смещение, длина» и занимает 4 байта.
- Элементы: Сами элементы данных как таковые.
- Свободное пространство: Незанятое пространство. Новые идентификаторы элементов размещаются с начала этой области, сами новые элементы — с конца.
- Специальное пространство: Специфические данные метода доступа. Для различных методов хранятся различные данные. Для обычных таблиц таких данных нет.
Выравнивание и паддинг: Физика хранения
В PostgreSQL границы выравнивания для типов данных определяются размером данных в байтах. PostgreSQL автоматически выравнивает данные в памяти для повышения эффективности доступа. Основные типы данных, такие как integer, bigint, real, double precision и другие, имеют фиксированный размер и, следовательно, фиксированное выравнивание.
Целочисленные типы:
- smallint: 2 байта, выравнивание по 2 байтам.
- integer: 4 байта, выравнивание по 4 байтам.
- bigint: 8 байт, выравнивание по 8 байтам.
Числа с плавающей точкой:
- real: 4 байта, выравнивание по 4 байтам.
- double precision: 8 байт, выравнивание по 8 байтам.
Строковые типы:
- char(n): выравнивается по размеру n, но на практике может быть выровнено до ближайшего большего кратного 4, если n меньше 4.
- varchar(n): выравнивается по размеру n, но на практике может быть выровнено до ближайшего большего кратного 4, если n меньше 4.
- text: выравнивается по размеру, зависящему от реализации, но обычно по 4 байтам.
Дата и время:
- date: 4 байта, выравнивание по 4 байтам.
- time: 8 байт, выравнивание по 8 байтам.
- timestamp: 8 байт, выравнивание по 8 байтам.
Другие типы:
- boolean: 1 байт, выравнивание по 1 байту.
- bytea: выравнивается по размеру, но на практике может быть выровнено по 4 байтам.
Механизм паддинга:
Если данные не выровнены, PostgreSQL добавляет пустые байты:
SELECT PG_COLUMN_SIZE(ROW(TRUE, 1::SMALLINT, 1::BIGINT)) - 24; -- 16 байт
Пошаговое расположение данных:
- Стартовая позиция:
- Адрес 0 (начало строки после 24-байтного заголовка).
- BOOL (1 байт):
Адрес 0: [ BOOL ] Текущая позиция → 1 - SMALLINT (2 байта, выравнивание 2):
- Требует адреса, кратного 2.
- Ближайший подходящий адрес → 2 (текущая позиция 1 не подходит).
- Добавляем 1 байт паддинга:
Адрес 0: [ BOOL ]
Адрес 1: [ PADDING (1) ]  ← выравнивание для smallint!
Адрес 2: [ SMALLINT (байт 1) ]
Адрес 3: [ SMALLINT (байт 2) ]
Текущая позиция → 4
- BIGINT (8 байт, выравнивание 8):
- Требует адреса, кратного 8.
- Ближайший подходящий адрес → 8 (текущая позиция 4 не подходит).
- Добавляем 4 байта паддинга:
Адрес 0: [ BOOL ]
Адрес 1: [ PADDING (1) ]
Адрес 2: [ SMALLINT (байт 1) ]
Адрес 3: [ SMALLINT (байт 2) ]
Адрес 4: [ PADDING (4) ]  ← выравнивание для bigint!
Адрес 8: [ BIGINT (байты 8-15) ]
Текущая позиция → 16
Итого: 1 (bool) + 1 (паддинг) + 2 (smallint) + 4 (паддинг) + 8 (bigint) = 16 байт
TOAST: Хранение «толстых» данных
Когда длина строки в PostgreSQL превышает примерно 2 КБ, система автоматически использует механизм «TOAST» (The Oversized-Attribute Storage Technique) для оптимизации хранения. TOAST сжимает или перемещает большие значения полей в отдельную таблицу, оставляя в основной таблице лишь указатель на данные.
Стратегии хранения:
SELECT attname, attstorage
FROM pg_attribute
WHERE attrelid = 'table_name'::regclass;
p (plain): запрет TOASTe (external): без сжатияm (main): сжатие в основной таблицеx (extended): сжатие + вынос (по умолчанию для TEXT/JSONB)
Преимущества TOAST:
- Эффективное использование пространства — позволяет хранить большие объёмы данных, не перегружая основную таблицу.
- Оптимизация производительности — запросы к данным, которые не используют большие значения, могут быть выполнены быстрее, так как не нужно обращаться к таблице TOAST.
Оптимальный порядок
-- Неоптимизированная таблица
CREATE TABLE bad_table (
  id serial,            -- 4 байта (после int идёт padding)
  notes text,           -- 4 + длина (выравнивание 4)
  created_at timestamp, -- 8 байт
  is_active bool        -- 1 байт
);

-- Оптимизированная
CREATE TABLE good_table (
  created_at timestamp, -- 8 (начало с адреса 0)
  id serial,            -- 4 (адрес 8)
  notes text,           -- 4 + длина (адрес 12)
  is_active bool        -- 1 (адрес 16+длина notes)
);
Результат для 1 млн строк:
SELECT
  pg_size_pretty(pg_total_relation_size('bad_table')) AS bad,   -- 57 MB
  pg_size_pretty(pg_total_relation_size('good_table')) AS good; -- 50 MB
                                                                -- экономия 14%
Важно:
- Выравнивание может немного увеличить размер таблицы, но обычно это незначительно.
- Эффект от выравнивания наиболее заметен при работе с большими таблицами и сложными запросами.
- В большинстве случаев нет необходимости специально настраивать выравнивание, так как PostgreSQL делает это автоматически.
Влияние порядка колонок на производительность SELECT и UPDATE
Как PostgreSQL читает данные (fastgetattr):
- Для каждой таблицы кэширует смещения (offsets) полей.
- При запросе поля использует формулу:
attribute_offset = offset_0 + (attribute_id * attribute_size) - Для переменных полей (text, jsonb) использует TOAST-указатели.
SELECT
Уменьшение размера страниц
Оптимизированный порядок колонок сокращает размер строк → больше строк помещается в 8-КБ страницу:- До оптимизации: 100 строк/страницу
- После: 120 строк/страницу (+20%)
Меньше страниц нужно читать для тех же данных → ускорение full scan.
Лучшая локальность данных
Часто запрашиваемые колонки группируются → меньше обращений к разным участкам памяти:SELECT id, created_at FROM table_name; -- Все колонки рядомКэш CPU используется эффективнее.
Снижение нагрузки на TOAST
Крупные поля (TEXT, JSONB) в конце таблицы → не читаются при запросах без них:-- Если payload в конце, этот запрос не загружает TOAST: SELECT id, created_at FROM table_name;Крупные поля не мешают быстрым запросам.
UPDATE
Уменьшение размера WAL
Меньший размер строк → меньше данных пишется в журнал транзакций:- Обновление строки 100 байт vs 70 байт → экономия 30% в WAL
HOT-обновления (Heap Only Tuple)
Если обновляются поля без индексов и новая версия помещается на ту же страницу:-- Статус без индекса + оптимизированный размер строки UPDATE table_name SET status = 'NEW' WHERE id = 100;Не требуется обновлять индексы.
Снижение вероятности TOAST-обновлений
Крупные поля в конце → их обновление не затрагивает основную строку:-- Обновление JSONB не перезаписывает всю строку UPDATE table_name SET payload = '{"new":true}' WHERE id = 100;Меньше блокировок
Короткие операции UPDATE → меньше времени удерживаются эксклюзивные блокировки.
Небольшое дополнение по UPDATE
Давайте возьмём нашу таблицу good_table и заполним её данными:
INSERT INTO good_table (created_at, id, notes, is_active)
SELECT
    NOW(),
    n,
    LEFT('123456789', 5 + n % 5),
    (CASE n % 2 WHEN 0 THEN TRUE ELSE FALSE END)
FROM GENERATE_SERIES(1, 1000000) gs(n);
Проверим ещё раз её размер и получим все те же 50 МБ:
SELECT pg_size_pretty(pg_total_relation_size('good_table')); -- 50 MB
Давайте обновим у всех записей поле is_active на FALSE (выберем только те записи, у которых is_active = TRUE):
UPDATE good_table
SET is_active = FALSE
WHERE is_active;
Посмотрим на размер таблицы:
SELECT PG_SIZE_PRETTY(PG_RELATION_SIZE('good_table')); -- 75 MB
Откуда взялось ещё 25 МБ данных, мы же обновили только одно поле, тот самый bool, который занимает 1 байт? Но если присмотреться повнимательнее, видно, что увеличение размера таблицы пропорционально количеству обновлённых записей — 50%.
Основная причина — MVCC (Multiversion Concurrency Control):
- Старая версия строки остаётся на диске как «мёртвый кортеж»
- Новая версия записывается в свободное пространство страницы (или новую страницу)
- Индексы пересоздаются для новой версии
Давайте обновим данные ещё раз, перепишем все флаги is_active на TRUE:
UPDATE good_table
SET is_active = TRUE
WHERE is_active = FALSE;
Посмотрим на размер таблицы:
SELECT PG_SIZE_PRETTY(PG_RELATION_SIZE('good_table')); -- 100 MB
Давайте обновим данные ещё раз, перепишем все флаги is_active на FALSE:
UPDATE good_table
SET is_active = FALSE
WHERE is_active;
Посмотрим на размер таблицы:
SELECT PG_SIZE_PRETTY(PG_RELATION_SIZE('good_table')); -- 100 MB
При повторном обновлении рост прекратился: третьи версии строк записались в области, освобожденные первыми версиями, демонстрируя главное преимущество MVCC — повторное использование «мёртвого» пространства без расширения файлов.
Всё, что необходимо сделать, — прибраться за собой:
VACUUM FULL good_table;
REINDEX TABLE good_table;
SELECT PG_SIZE_PRETTY(PG_RELATION_SIZE('good_table')); -- 50 MB
Золотые правила оптимизации
- Порядок колонок влияет на размер таблиц до 30%.
- Группируйте столбцы по размеру выравнивания.
NULL-колонки — в конец: они занимают только 1 бит в заголовке.
TOASTавтоматически решает проблему больших данных, но требует настройки:ALTER TABLE logs ALTER COLUMN payload SET STORAGE EXTERNAL;- Используйте
VACUUM FULLпосле массовых изменений:VACUUM (FULL, ANALYZE) table_name; - Проверяйте через
pg_column_size:SELECT pg_column_size(ROW(your_columns)) FROM table_name LIMIT 1; - Проверяйте через
pageinspect:CREATE EXTENSION pageinspect; -- Заголовок страницы SELECT * FROM page_header(get_raw_page('table_name', 0)); -- lsn = '0/E92510B0' AND checksum = 0 AND lower = 292 AND flags = 4 AND version = 4 AND pagesize = 8192 AND upper = 304 AND special = 8192 AND prune_xid = '0' - Выравнивание данных зависит от архитектуры процессора (на
x86_64актуальны 8-байтные границы).
Домашнее задание
SELECT PG_COLUMN_SIZE(ROW(1::SMALLINT, TRUE, 1::BIGINT));
SELECT PG_COLUMN_SIZE(ROW (TRUE, gen_random_uuid()));
SELECT PG_COLUMN_SIZE(ROW (NULL::bool, ''::text)) - 24;
